
 Алгебра
 Английский
 Биология
 География
 Геометрия
 История
 Русский
 Обществознание
 Физика
 Химия
 Информатика
 Литература
 Математика
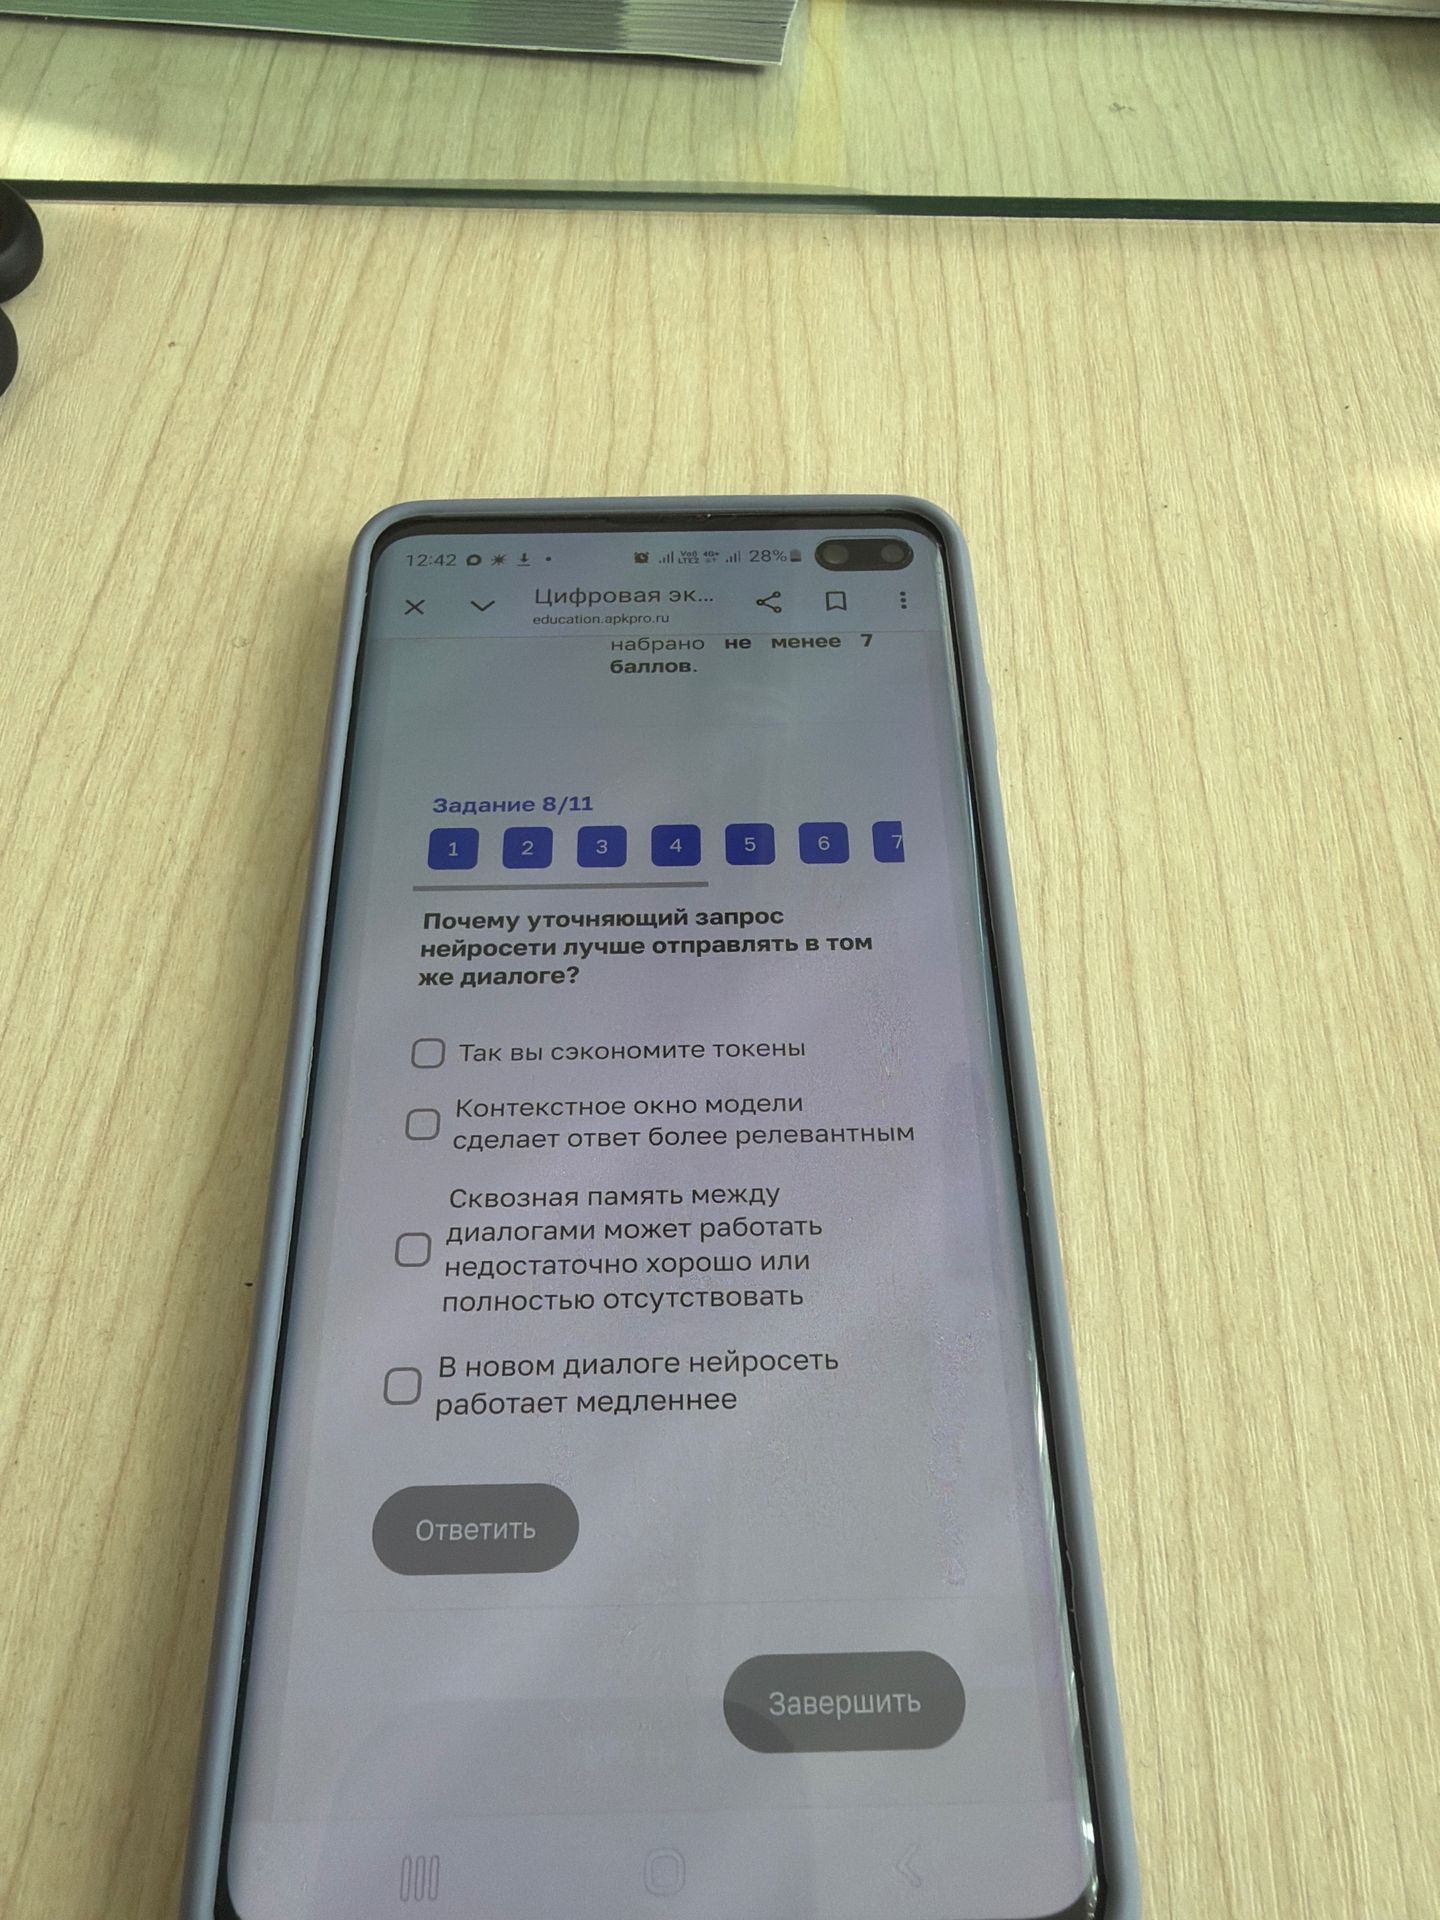
Ответ:
Уточняющий запрос в том же диалоге сохраняет контекст предыдущего общения — модель может учесть уже заданные условия и дать более релевантный ответ. Между разными диалогами память может быть ограниченной или отсутствовать. Это не означает экономию токенов или более медленную работу модели в новом диалоге.
Ответ: варианты 2 и 3.
