
 Алгебра
 Английский
 Биология
 География
 Геометрия
 История
 Русский
 Обществознание
 Физика
 Химия
 Информатика
 Литература
 Математика
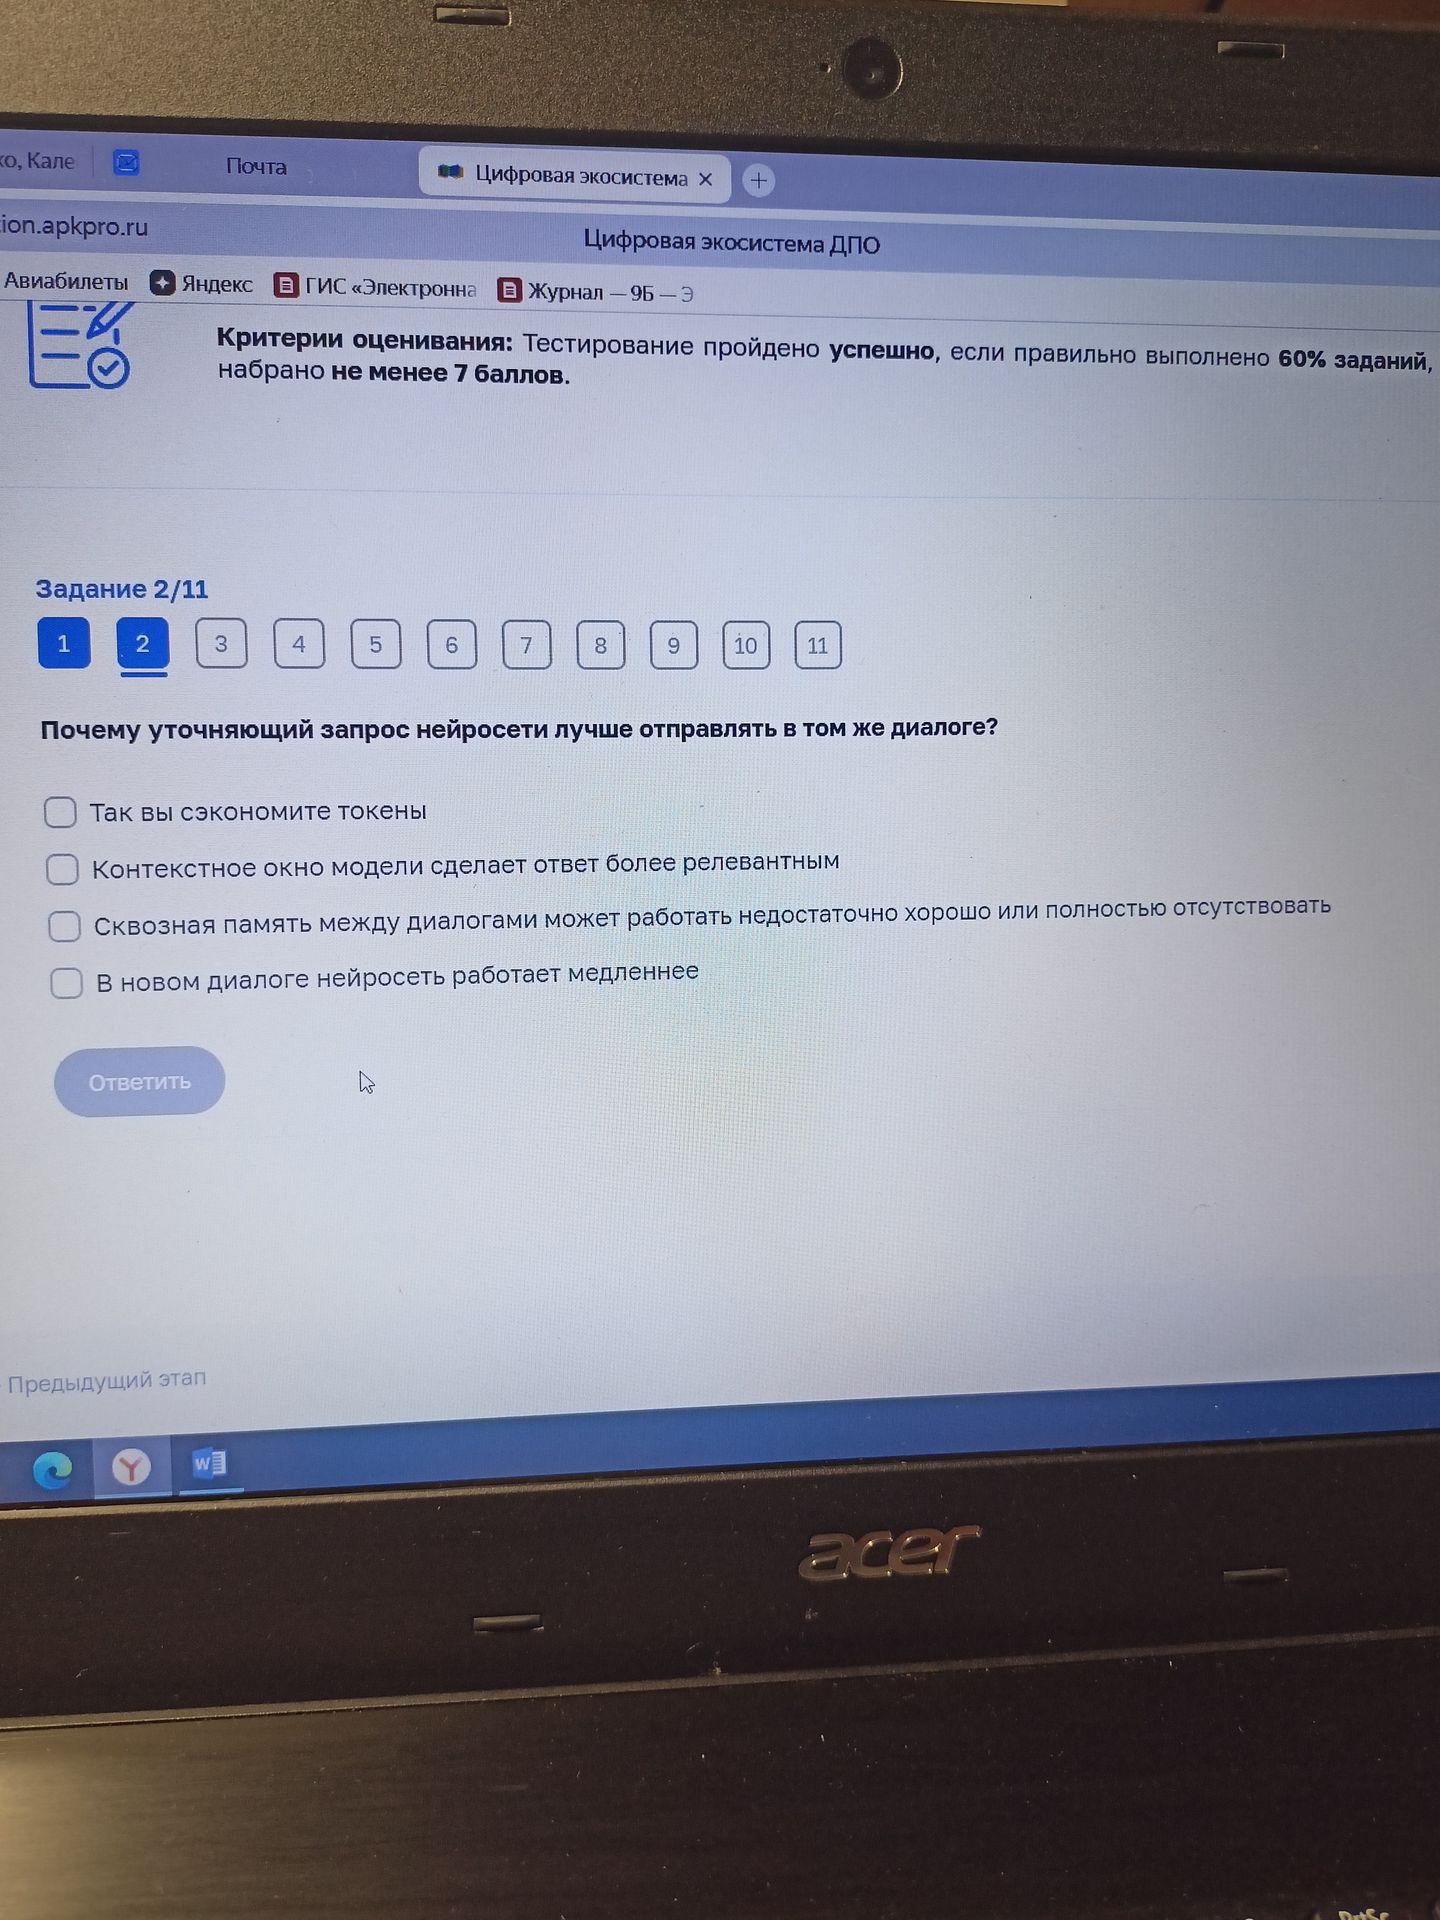
Ответ:
Верные варианты: 2 и 3. В том же диалоге модель видит предыдущие сообщения и может использовать их контекст, поэтому ответ обычно точнее. Между отдельными диалогами память может быть ограничена или отсутствовать. Экономия токенов и более медленная работа нового диалога не являются верными обоснованиями.
